编译: SSA#
SSA中最重要的一点就是只保留值的关系。
在静态分析程序的行为的时候,“某个变量在某个位置被使用,这时候变量内的值是什么?” 是一个重要的问题。
在程序真正运行或者动态分析的过程中,变量其实代表了某个通过名字可索引的位置,这个位置可以存放一个值,重复赋值会被覆盖。
数据流部分#
值和变量
变量和值的关系有点类似于c++中的左值右值,
变量我们指可以存放值的地方,作为索引找到值。在高级语言中可能表现为变量、成员;在低级的汇编等可能表现为寄存器、栈内存和堆内存。
c++中的左值的解释是“占据内存中某个可识别的位置的对象”
值我们指那些真正被用于计算的数据,他们要么是单纯的数据要么是一块有结构的(实例/内存)里面存了数据。
在动态的情况下这些值基本上都是确定的那些数据。但是静态的情况下我们无法获取到这些,所以会用常量、形参、运算、调用来表达一个无法确定的值。
phi的特殊性
在面对控制流时, 一个变量内的值会出现不确定性,动态分析将会在执行过程中直接确定具体的数据是谁,而静态分析无法确定。而Phi指令本身作为一个值,他表达多个值的多选一关系。
在大部分的静态分析都会遇到这样的问题:
- 常见SSA格式的IR中使用Phi来处理
- 部分特殊SSA格式使用基本块参数来处理
- 非SSA格式会使用不动点计算的传统数据流分析方式来处理
- 符号执行框架会直接路径爆炸…… 动态符号执行会要求模拟动态执行的接入……
一般会要求Phi指令的每一个值对应前序的基本块,这样保证Phi指令和整个CFG的统一。但是我们目前没用到这一特点。
控制流部分#
线性执行流程
这部分比较简单,如果只是单一语法块内直接通过名称覆盖即可。简单来说变量在程序真正运行的时候就是一个不断被值覆盖的名字,每次通过名字索引都会找到最近的一次覆盖,这个逻辑可以直接通过一个类似map[string]ssa.Value的结构表达。然后SSA部分提供对于变量的读写API即可。
最开始的SSA版本就是map,具体的做法在
SSA旧版备份分支和 参考论文现在的这一部分内容接入到了Scope内,通过一个不断增长的单向链表表达。
a = 1      // set a = 1
println(a) // get a (1)

a = 2      // set a = 2
println(a) // get a (2)
复杂控制流
在静态分析过程中其实是没办法处理控制流的,一般的做法就是切分基本块然后转变成判断+跳转的底层形式。
在YakSSA指令设计里头的控制流指令保留了比较高级的语句比如loop/try/switch,同时关注的重点是数据流如何,控制流其实是为了数据流服务的。
a = 0             // set a = 0
if condition {
    a = 1         // set a = 1
} else {
    a= 2          // set a = 2
}
println(a)        // get a  !! phi(1, 2)
因为我们是从AST直接向SSA转换,所以可以明确的知道某个语法结构,并且预先定义好他们转换为SSA以后的样子。提供特定的API直接使用。
这些API定义在 yaklang\common\yak\ssa\cfg.go 提供一些像填空一样的API 自动转换为对应的结构。
这个文件主要提供的是关于IR的控制流图(也就是基本块关系相关逻辑)向下调用 yaklang\common\yak\ssa\ssautil\cfg.go 内代码,这一部分提供值和Scope相关的计算,真正的生成PHI。
特殊处理
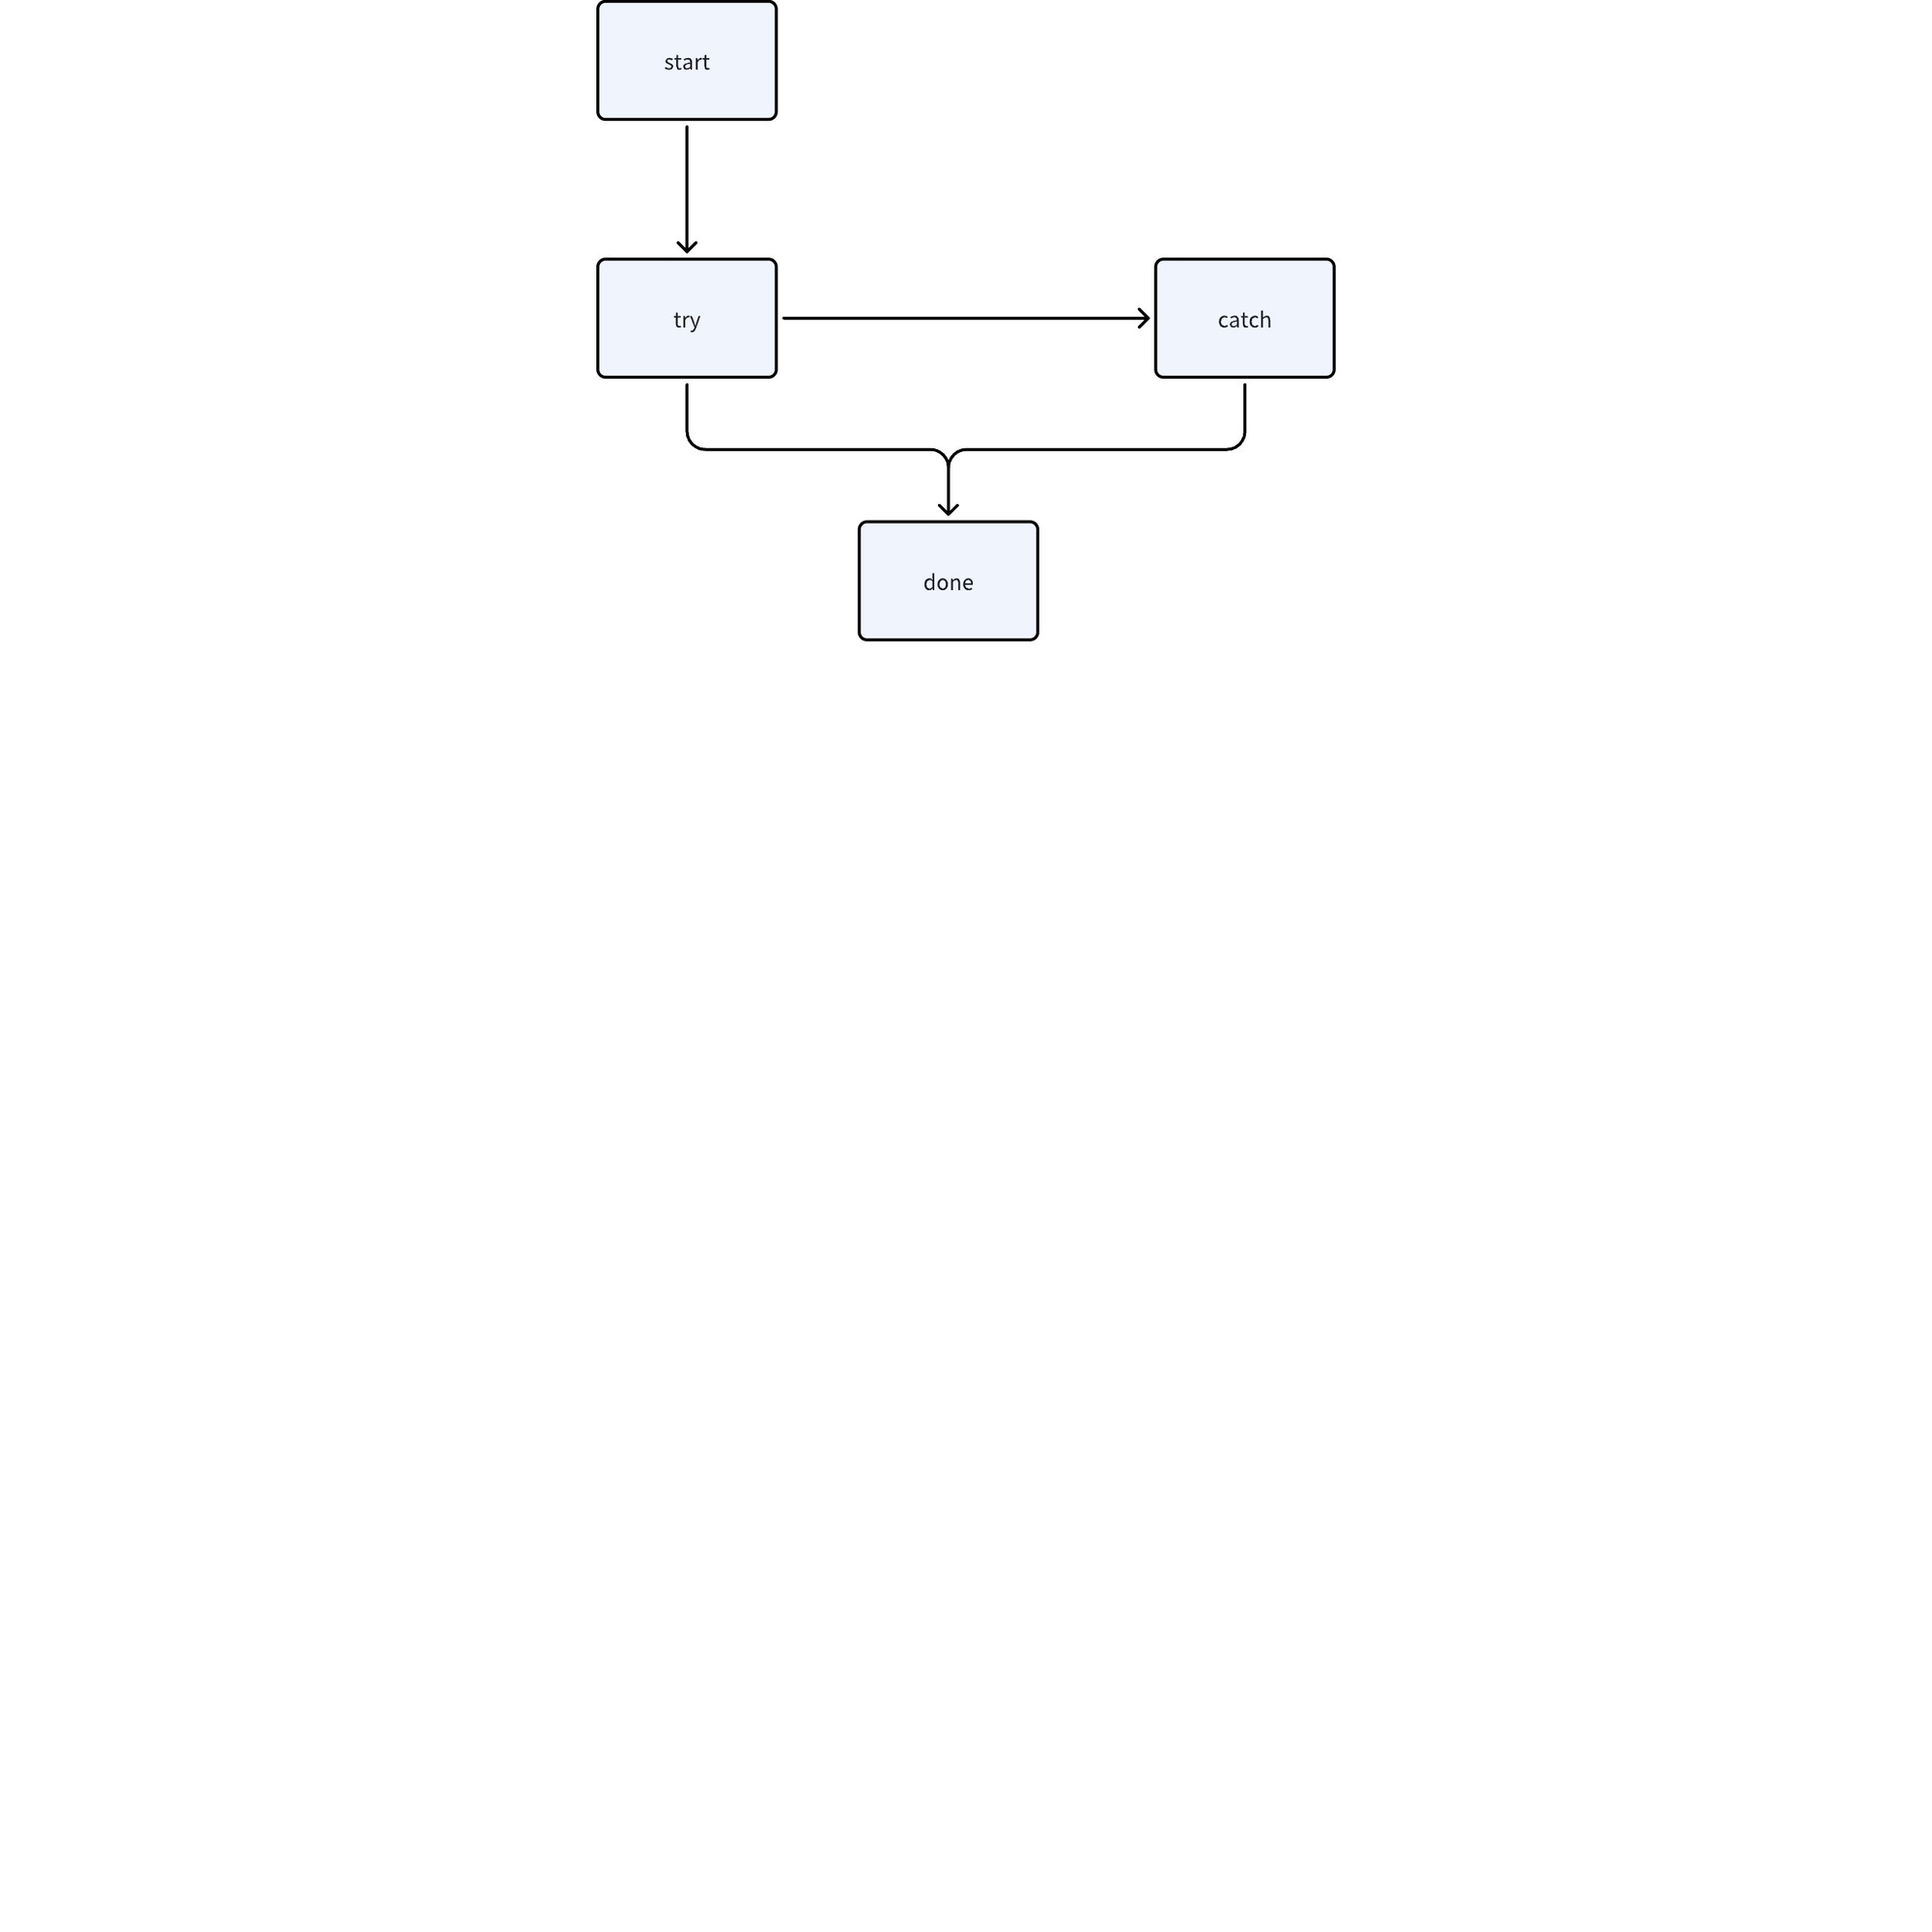
因为前文提到CFG产生的PHI语句一般要求保证其中的数据和前序基本块对应,这样数据流分析也会在正确的控制流路径上。
我们目前的分析基本上是直接在数据流图上(或者是只依赖数据流关系分析),因此这个特点并没有用到。
为了保证这一点控制流图的基本块排布其实会显得有一些怪异,来保证这一点。
// block1
try {
// error-try-block
    a = 1
} catch err {
// error-catch-block
    a = 2
}
// error-done-block
println(a) // phi (1, 2)
这里最后的a一定会是phi,因此try和catch的基本块都会是done的前驱。
Block-condition
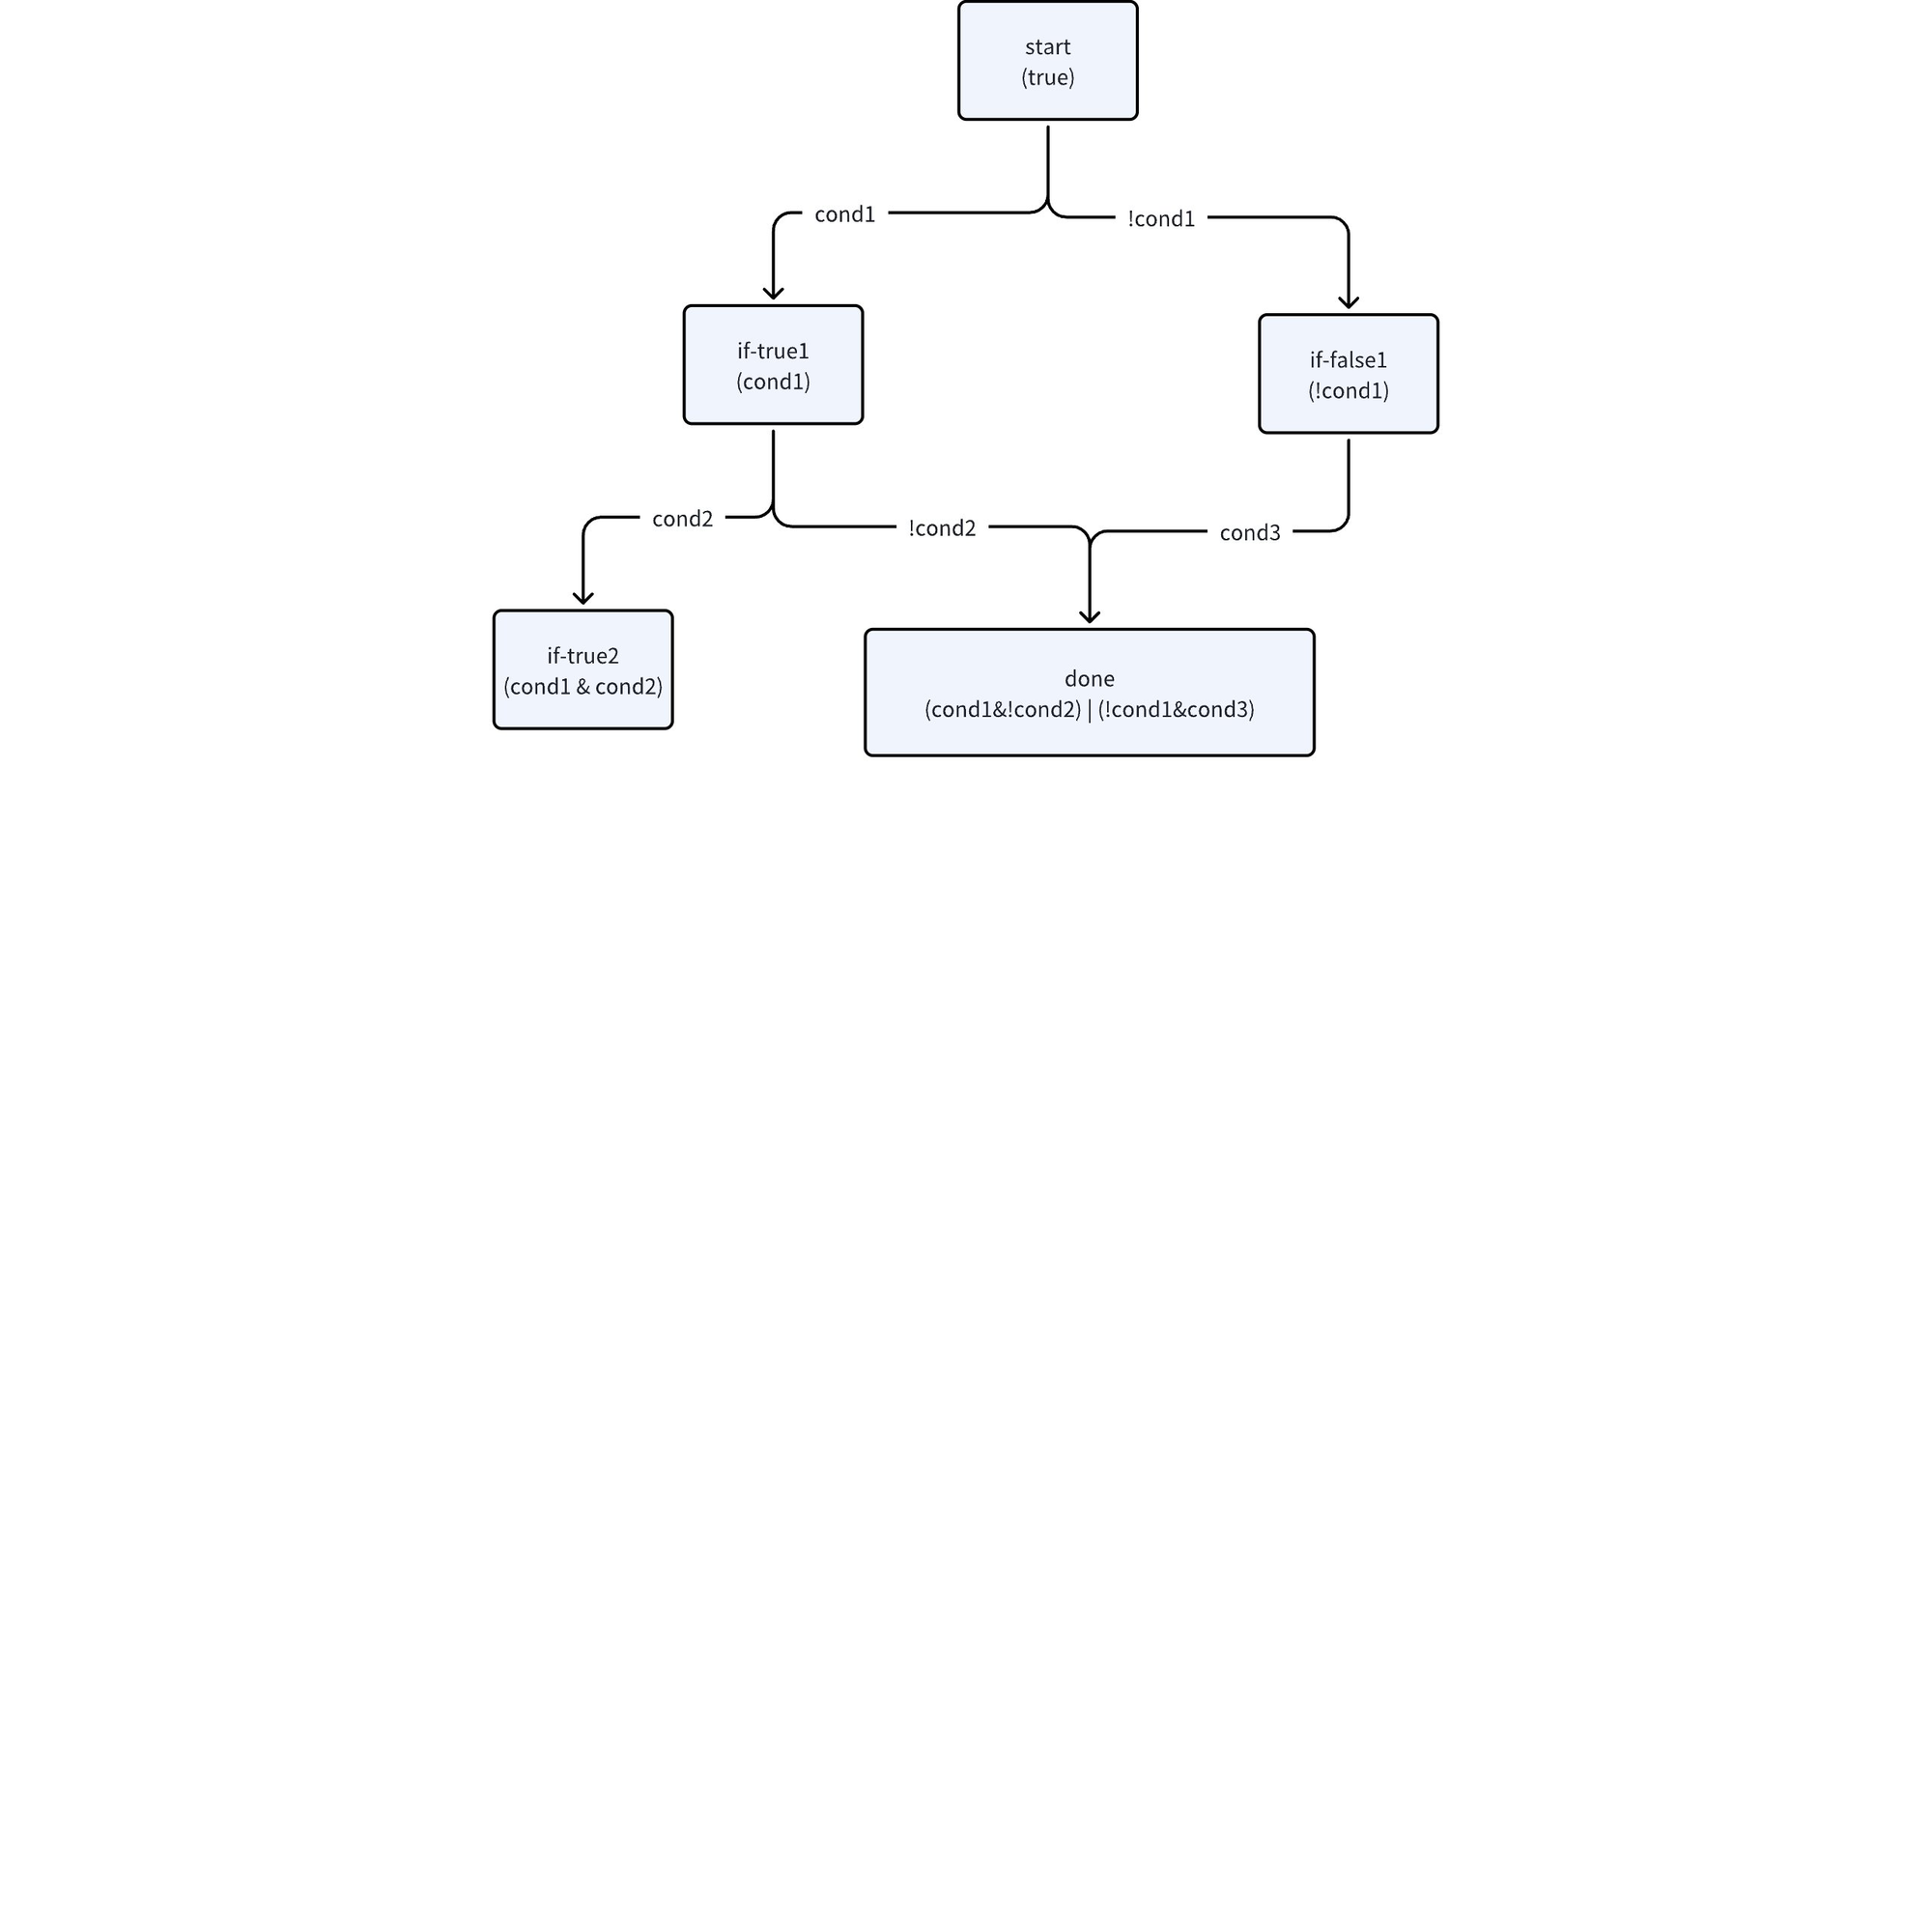
一个目前未启用的机制, 确定函数开头一定是true,然后将会按照控制流指令提取分支条件并且计算每一个block从函数开头运行到当前位置的条件。
因为每个指令都是有函数和基本块的,因此分析结果中的指令可以直接获取到某个位置的可达条件。用于分析结果或者排除。
指令设计#
按照上述的概念,主要的数据流指令:
- 普通数据流指令: 常量、形参、运算、函数调用
- 特殊数据流指令:PHI
- 控制流指令: if/loop/try/switch
- 特殊指令:比如panic/recover/typeValue/typeCast
Scope#
在没有作用域之前,Phi的生成是通过CFG API控制基础块的排布最后生成Phi,语法块作用域不对外产生影响则是通过修改变量名的方式。在面对复杂问题时会出错。比如复杂流程中某些子作用域不对外产生影响。
因此在SSA生成的过程中,变量读写和cfg产生PHI的API也直接接入scope来处理。
Scope内会自动维护变量和产生PHI,只需要调用对应PHI进行cfg的构建以及变量读写即可。
subScope
因为Scope还是要接入到SSA项目中的,并且也负责cfg部分。因此自然的将其和基本块绑定起来。于是在SSA的cfg接口里,创建对应基本块后调用scope相关的API然后将scope和block “一一对应”。这样两者都是正确的。但这引来了两个有些奇怪的点:
// scope1
a = 1
f()
{
    // scope2
    a = 2
    println(a) // 2
// } ---
a = 3
println(a) // 1
} +++
- 对于block来说会存在冗余:
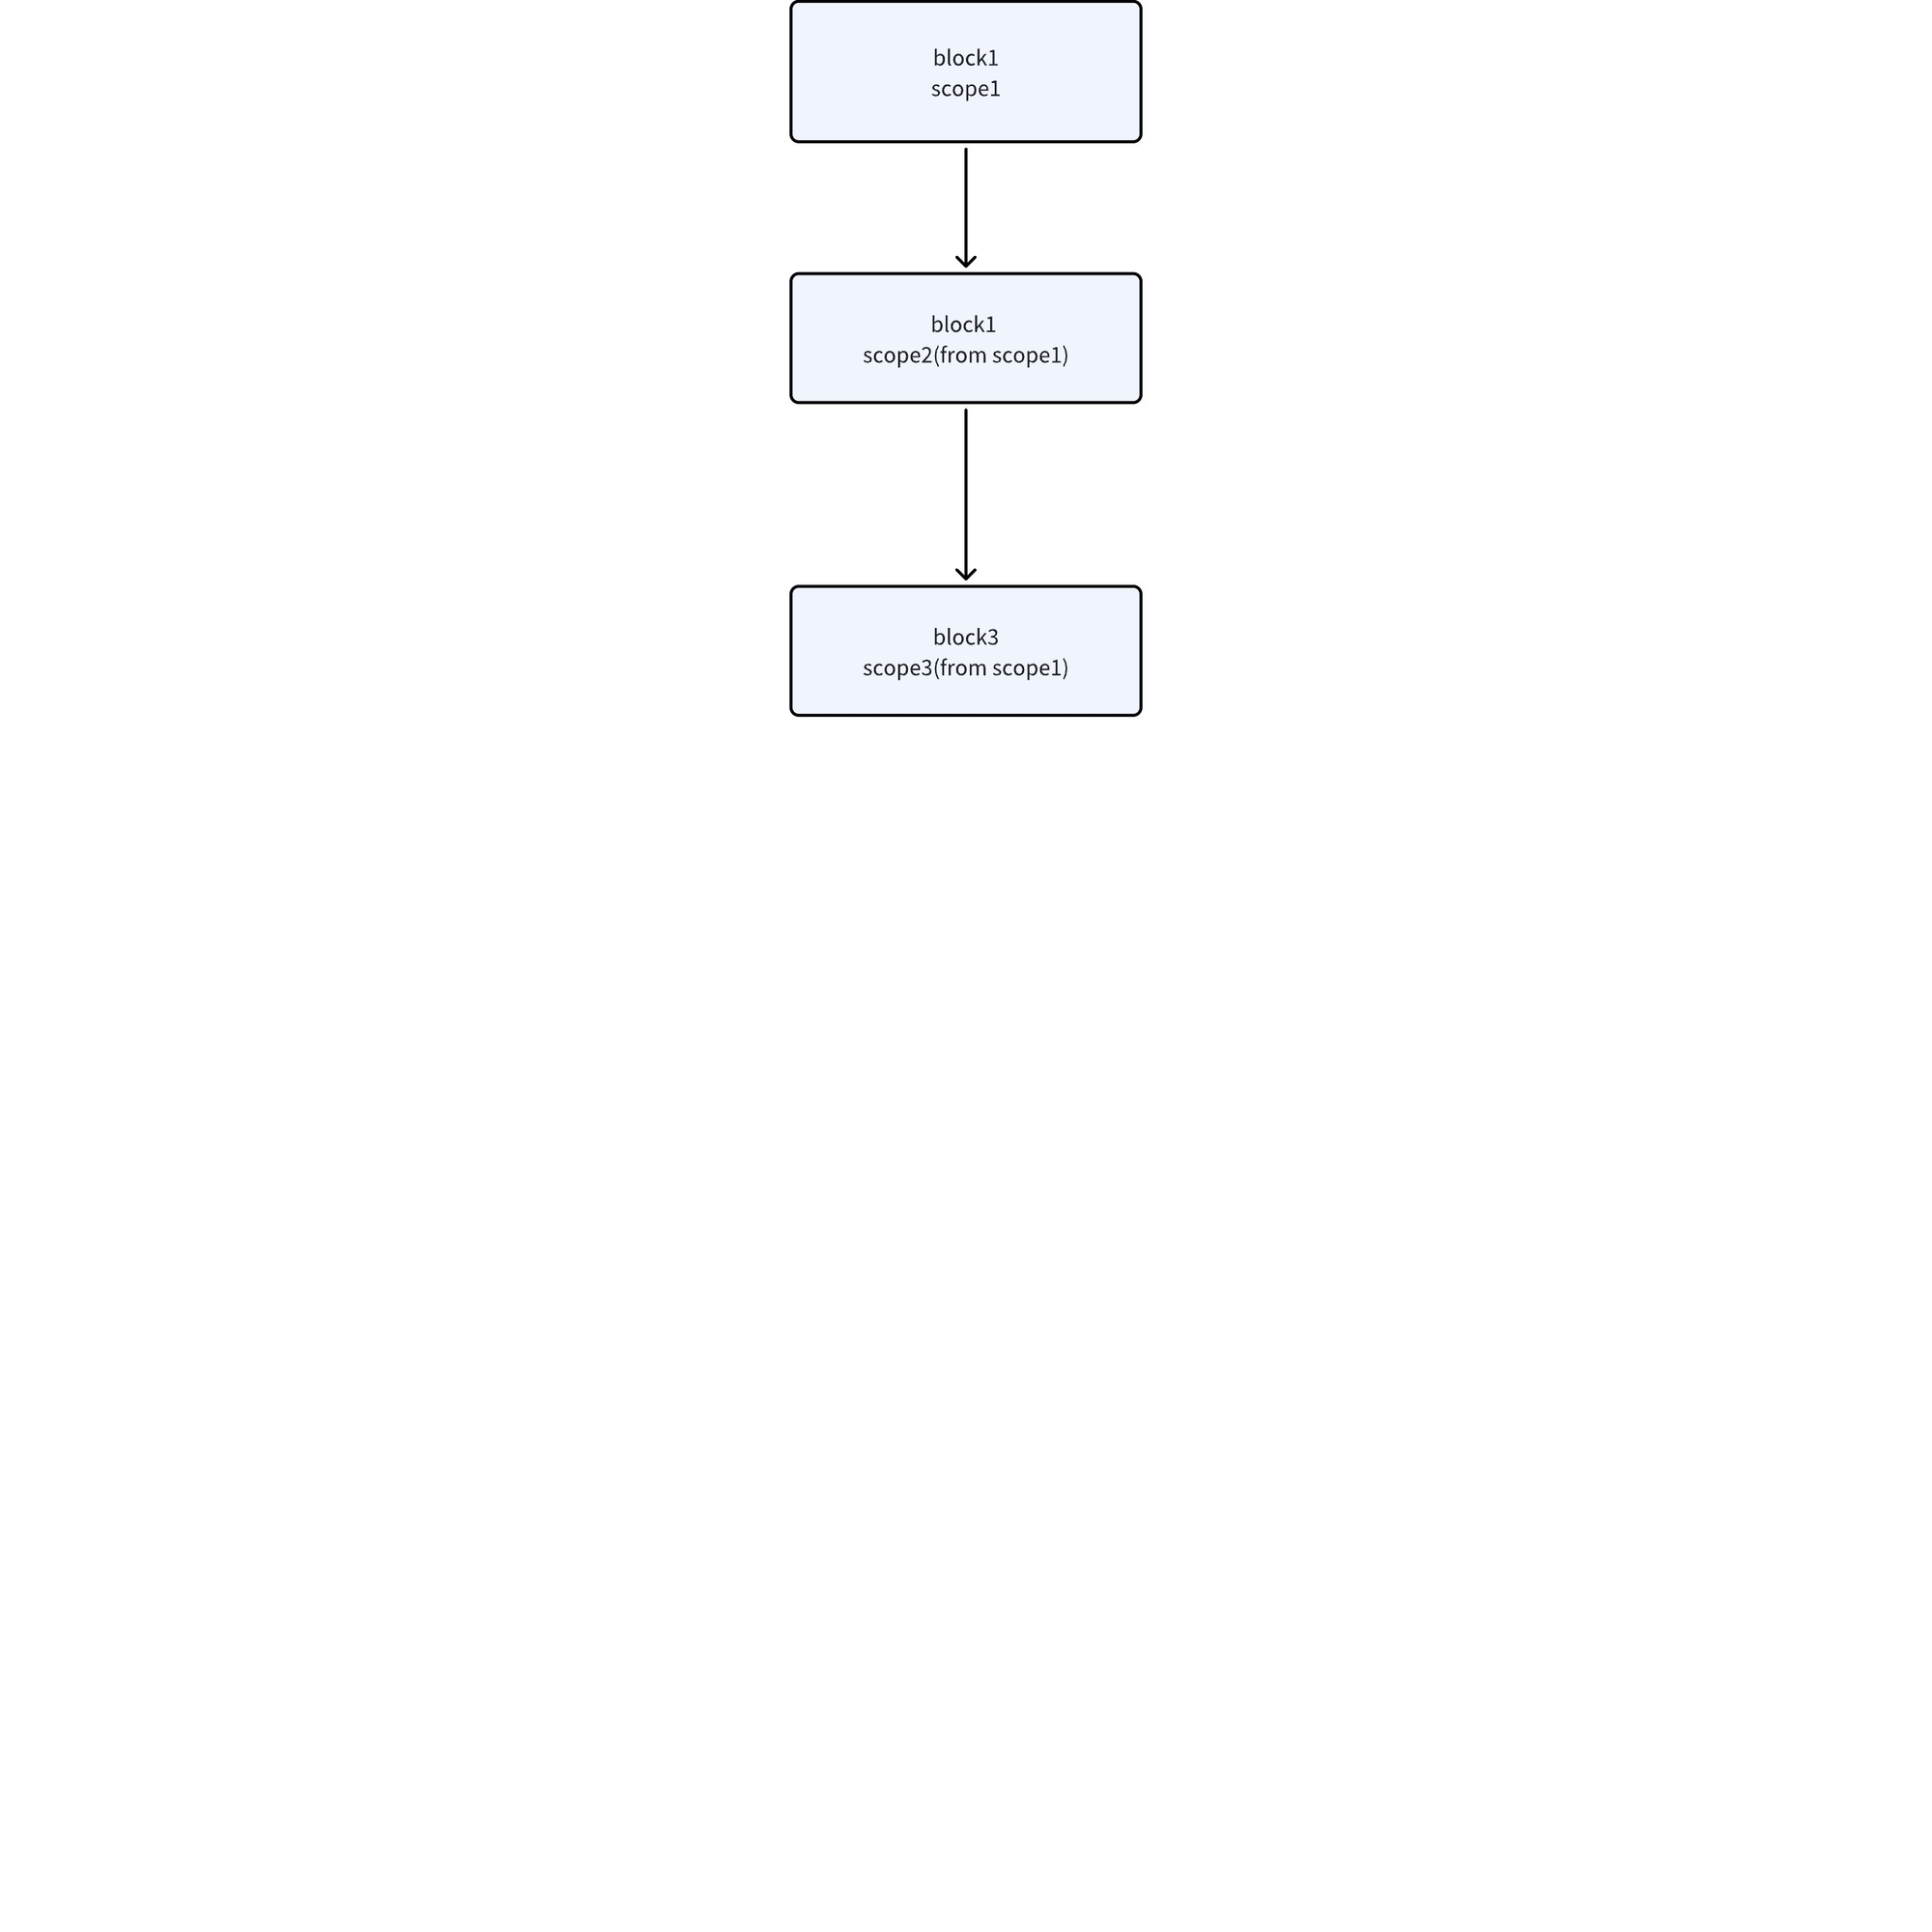
以上的代码因为scope2的存在,则一定会分单独的基本块,于是scope1对应的基本块跳到了scope2的基本块,而最后的println则需要scope2基本块跳到一个新的,于是将会有三个基本块,block1->block2->block3,而且只是单纯的jump。
- 对于scope来说需要切割额外的scope
因为上述的block需要三个,因此scope也需要新的,因此将会在创建一个subscope来表示语义上后续的scope1。
另一个考虑是如果block1和block3共用,可能会出现block1内读取到a = 3的可能,比如某个函数需要对相关引用fixup,则可能要求重新读取变量。
在处理复杂作用域的时候单纯的创建子作用域是不足的。
shadowScope
Scope内存的数据有:
- Variable 一个链表,表示当前改变量内部存的值
- captured: 表示当前作用域对外部作用域有修改的变量。在合并作用域时将会进行处理。
Scope之间的处理有:
- coverBy: 将子作用域合并进来,子作用域的 capture 直接覆盖当前的值。
- Merge: 将多个子作用域合并在一起,子作用域中的caputre将会产生phi。
- Spin: 表示自选,用于循环中,也就是一开始就设置为PHI,然后循环结束以后处理作用域,如果phi中只有一个值直接去掉phi,如果有多个值则保留。
// scope1
i = 1
{// scope2 (from scope1) capture(i)
    i = 2
    { // scope3 (from scope2)
        ...
    }
    // scope4 (from scope2, coverBy socpe3) // shadow capture(i)
}
// scope5 (from scope1, coverBy socpe4) // shadow
这里有一个bug是,scope的captured表示当前作用域捕获的外部作用域的变量,这是单层关系所以不会继承给subscope,但是我们可以发现scope5是合并的scope4而非scope2,因此表达 “语义上后续scope2” 的scope4是和scope3同样是scope2的subscope但不等价,scope4需要保存captured。因此用shadownscope来表达这个特殊的scope,其他的用subscope来表示。
Scope的数据库耗时问题
之前scope是整个存入到数据库中并恢复的,当时scope内的variable也是被保存为Map[string][]value,但在数据库的存取中就需要序列化和反序列化整个map和slice嵌套。
后续改成了一个链表并且保证每次取最后,这样整个scope的数据库存入只是不断存入单条variable-value关系,在这个数据库中增加scopeName一项,甚至不需要单独保存整个scope表也可以恢复。
闭包#
闭包将会捕获外部的变量以及修改外部变量。选择了拓展函数定义的方法处理:
- 函数将会被解析为:
func Name (parameter), [freeValue] | return side-effect-mark - 函数调用会被解析为:
call function (actual paramenter) [binding]+side-effect
生成side-effect的代码在函数调用点 yaklang/common/yak/ssa/call.go
成员#
在最开始,成员问题是通过常规的field指令解决的,但是field和update指令会引来新的问题:
- field本身类似于变量使用,而update类似于变量赋值,那么又会面临一个问题:某个field的某个位置的值是啥。
这个问题绕回了变量和值的问题,因此我们将成员也看成变量的一种。这样过程内的问题基本可以被解决。
但是过程间的操作会出现问题
f = (a) => {
    return a.b
}
f({"b": 1})
在这样的例子中,函数内获取到了a.b其中的a是形参,这时肯定需要将a.b和实参的1关联起来。这里的做法是继续拓展函数声明。
func Name(parameter) [freeValue] [ParameterMember] | return side-effect-mark
call function (actual parameter) [binding] [actual parameter mebmer] + sideeffect
对于函数的输入:
- 提出ParameterMember,并且要求调用点传入该参数。
- 对于内部对object的修改,要求产生side-effect。并且覆盖原本的数值。
这时候的在函数调用处理产生了新的机制:
-
ParameterMember的要求是某个形参/freeValue/另一个ParameterMember 作为Object以后取其成员。于是在函数产生的时候,就形成了某种对object的索引+key的标记。而在真正的函数调用点将会获取真正的实参/binding/其他parameterMember, 然后取其成员。
-
SideEffectMark的标记是同样的,而且因为它表达的是函数内对于某个成员的修改会影响函数外的数据,对于Object的取值将会更加宽泛。
- 函数外部输入:parameter/freevalue/parameterMember 这三种是比较常见的,也就是输入函数内的数据产生成员修改。
- 函数内部的值:Return返回值是一个函数内部的对象,他的成员需要反映到函数外部。则在产生SideEffect的时候object是函数调用本身。一个side-effect修改外部变量且是一个内部对象时,也会产生成员的sideEffect,其object指向是另一个side-effect。
OOP#
对于OOP的处理现在主要依赖类型。将其转换为一个个实例+平铺的函数+this/reciver指针的形式。
a = new A (1)

a = undefine-A
a = call A-constructor(a, 1)
a.a = sideeffect 1

func A-constructor(a, pa){
    a.a = pa
    return a
}

func A-constructor(class-instance, pa){
    obj = make()
    for key,field := class-instrn{
        obj.key=field
    }
    obj.a = pa
    return obj
}
包和导入导出机制#
现在使用的PckageLoader机制提供两个接口:BuildFilePackage BuildDirectoryPackage
然后对于import和package声明的语言:
- 尝试直接获取该program
- 如果获取不到尝试寻找路径并且构建该program
对于use和namespace:
- 首先第一次编译解析所有的namespace和class、function声明。
- 第二次编译use可以直接获取到某个确定的namespace并获取到其内部的成员、类型、函数。
- 当时用到某个函数、类型的时候,将会真正的去构建这个实例。
对于include:
- 直接将include的文件找到然后合并成为同一个程序。
应该全用use-namespace的方案,之前的php采用这一方案但是有bug,而golang和java使用第一个方案可能存在仅通过packageName找不到对应文件的情况。
但是同样面临一个问题: 前面提到的成员导致的函数定义修改,特别是side-effect将会可能遇到函数声明需要内部实现的解析的情况。
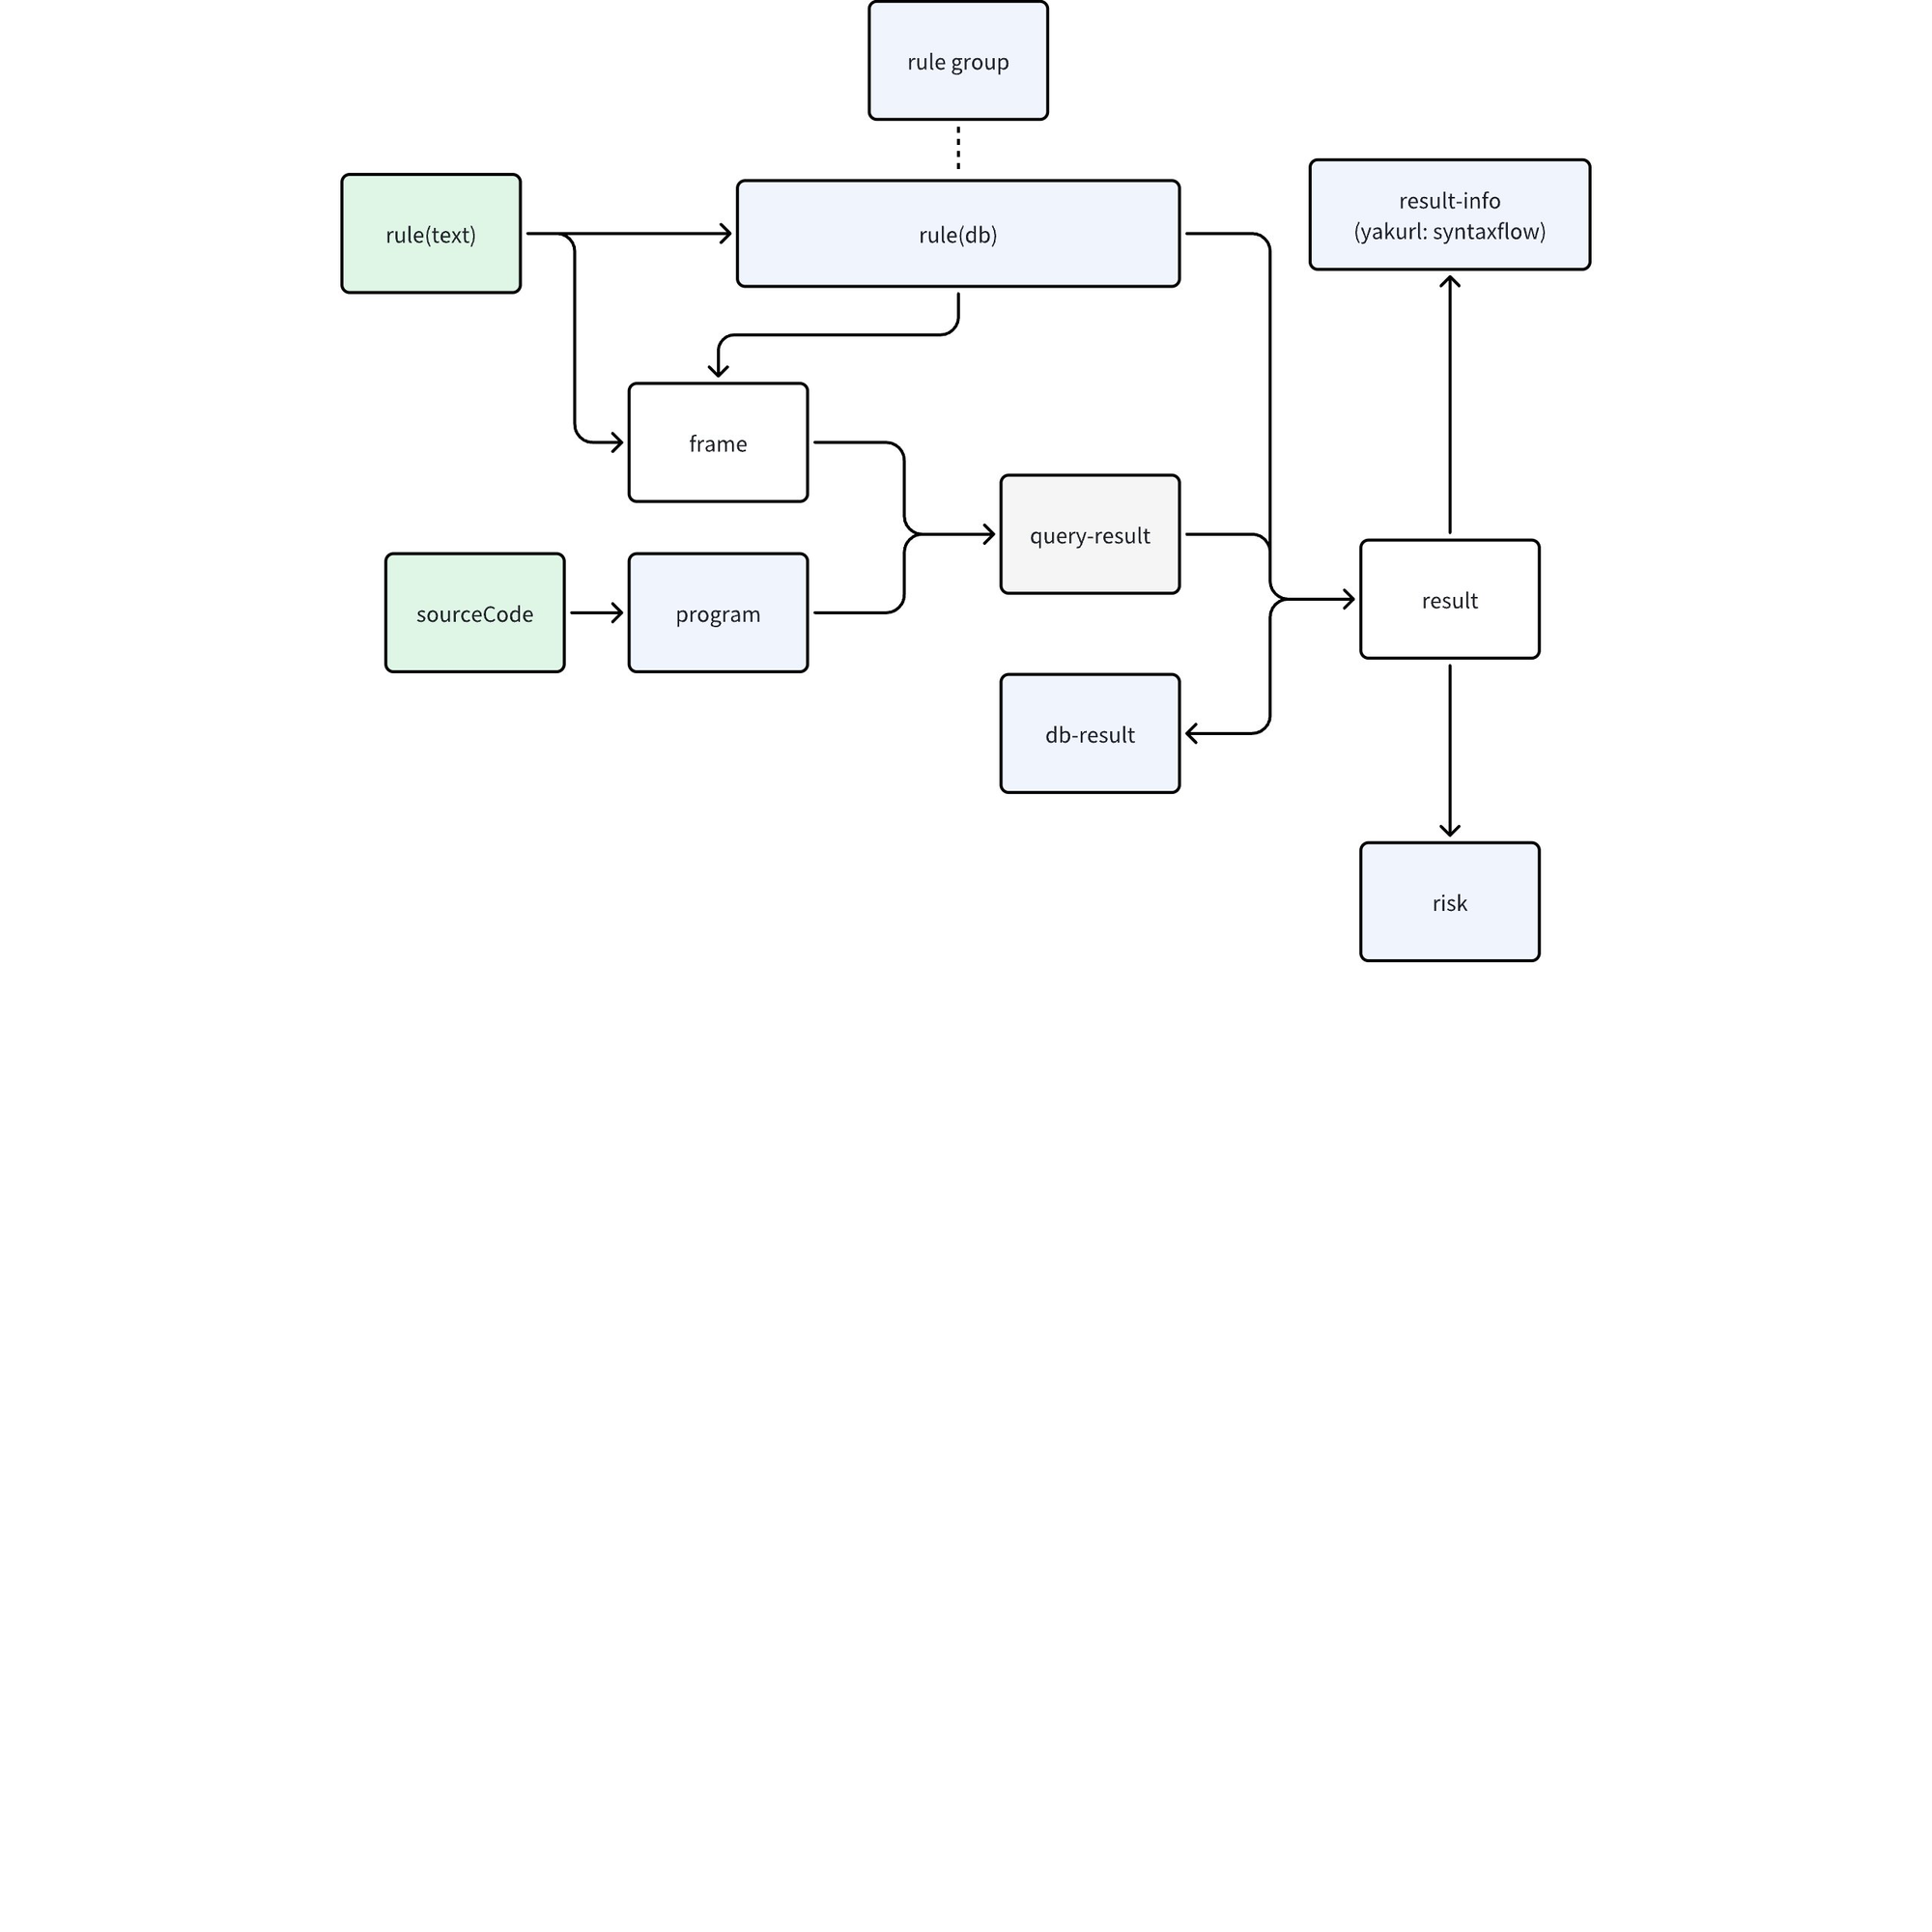
分析: Syntaxflow#
数据流分析#
跨过程分析
主要是 yaklang\common\yak\ssaapi\exclusive_z_top_defs.go和exclusive_z_bottom_use.go中,功能是实现了跨过程的数据流分析。一般情况下根据数据流关系组成的数据流图,可以直接顺着数据流进行分析。比较特殊的就是跨过程指令。
跨过程主要解决的问题:实参和形参,返回值和函数调用,side-effect和内部的值。
其中side-effect可以直接通过数据流找到,其他两个需要维护一个调用栈,来维护当前的调用者是哪一个。
而同时,调用栈是一个嵌套的数据结构,来维护这个需要通过一个栈来表达。
f = (a) => {
    return a
}
target = f(1)
负栈
在完成了正向的处理以后,很快会发现一个问题,如果分析一个形参,而同时调用栈不存在的话,则期望找到所有调用点并找到对应的实参,然后继续分析。
f = (a) => {
    target = a
}
f(1)
之前的负栈并没有设置去重,导致会产生递归。
目前的修复是制造了一个反向栈方向的增长,但是带来新的问题是,负栈的push和正栈的pop是同方向但不同行为的事情。
f = (a) => {
    target = a
}

f2 = (a2) => {
    return a2
}
num = f2(1)
f(num)
我目前在考虑的点是:
- 用栈的原因是因为正向的函数调用需要通过栈来表达这一个嵌套的数据来获取当前的实参。
- 但是反向的跨函数并不需要保存这个数据,因为就是这个数据没获取到才使用负栈
- 两个方向的跨过程都需要检查重复。
应该只需要做跨过程重复检查和正向的调用栈即可。
分析结果#
对于一次查询的分析结果。将会有若干的变量,变量内有若干的值,每一个值都有其分析路径和分析过程图。
同时会可能出现漏洞检出,检出的漏洞或风险表现为一个变量,也就是可能涉及多个位置。
分析过程图#
整个分析过程会被保存,在syntaxflow部分的控制流会通过Predecessors保存前一个值,在数据流分析部分会通过EffectOn和DependOn指向数据流分析过程中的前一个或后一个。
整个分析过程得到的所有值都通过这三个指针连接起来。
在前端会画出某个值的分析路径和分析过程图,其实就是在这个大图上,从某一个点开始向前深度优先搜索 得到路径,然后所有的点和关系整合起来得到分析过程图。
在数据库保存分析结果的时候,整个图被保存为点和向量。
用户接口#