在命令行中给新的yak增加了一个ssa子命令,用于使用ssa解析和分析代码。
使用流程:
- 使用yak ssa 进行项目编译,编译到数据库内储存
- 使用yak ssa进行代码分析,从数据库内查询并且分析代码。
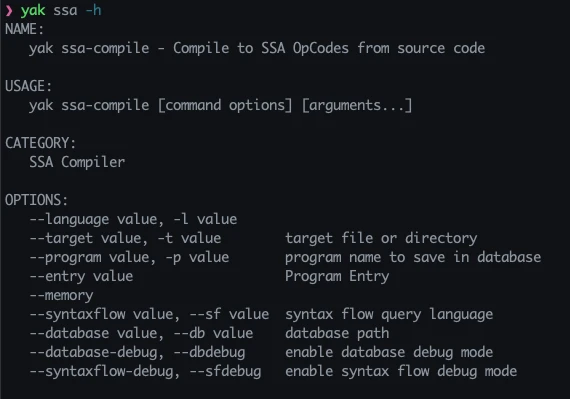
编译项目#
必须参数
-l--language表示项目需要解析的语言,如果不指定的话将会在遍历项目的时候通过文件后缀自动选择,目前YakSSA支持的语言有:YaklangJavaJavaScriptPHP-t--target需要分析的文件或项目的路径-p--program项目名称,这个是该项目的指定名称,后续的查询也是通过这个项目名来确定分析哪些代码的--entry项目入口文件,如果设置的话将会从该文件作为入口进行编译
yak ssa -p oa -t . -db ./oa.db
分析项目#
必须参数:
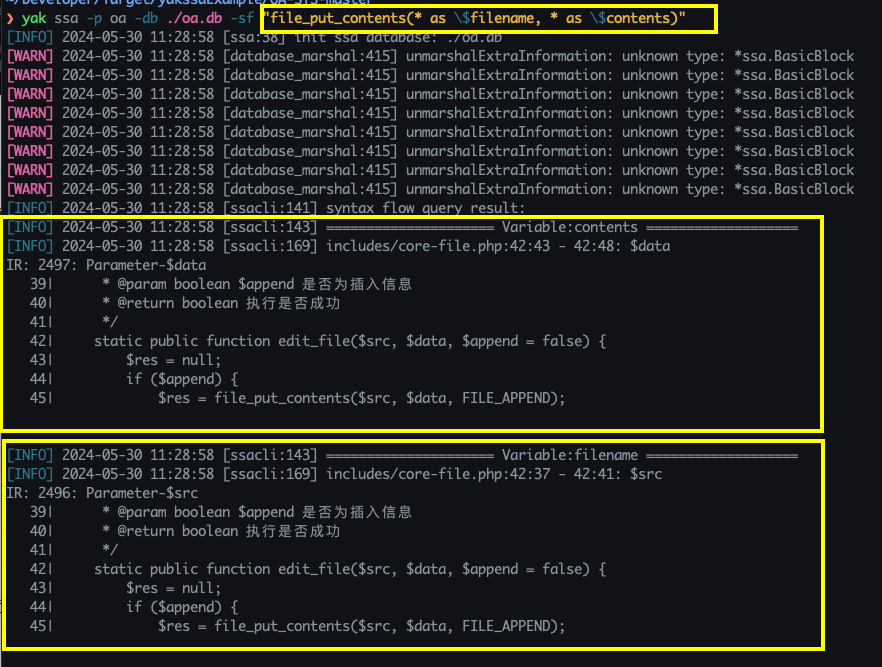
-p--program,项目名称,和编译时指定的项目名一致。-sf--syntaxflow, syntaxFlow查询语法,使用SyntaxFlow语言编写查询规则,运行后将会返回结果。
数据库#
使用-db --database可以指定数据库位置,将会使用指定的位置创建数据库并且将本次编译的数据写入该数据库。
如果没有指定的话,默认数据库位置在:$YAKHOME/default-yakssa.db
SyntaxFlow#
为YakSSA设计的查询语法。YakSSA中将会把代码编译为一个大的数据流图结构,主要用于静态代码分析中的数据流分析。
因此主要的功能为:
- 通过查询语句找到特定的变量,也就是找到数据流图上的点。
- SyntaxFlow可以编写多条语句,其中的每一条语句都会保证执行时互相不干扰,在每条语句中,可以将数据保存到变量内。
- 然后通过数据流分析的语法进行数据流分析,找到一些数据流图上的点以后就可以计算这些点的关系。
- 对于查找部分可能还需要增加很多过滤相关的工作
查询#
查询这部分的语法主要是为了符合直接搜索时的习惯。类比直接在某个代码编辑器进行代码搜索应该比较好理解。
    | nameFilter                                            # PrimaryFilter
    | '.' nameFilter                                        # FieldFilter
    | filterExpr '.' nameFilter                             # FieldCallFilter
syntaxflow可以进行的查询可以使用三种匹配方案:
- glob:如果存在
*将被视为通识符,将会进行glob语法的查询 - 正则:如果使用
/xxx/其中xxx将会被认为认为是正则表达式,并且使用该正则进行查询 - 完全匹配:如果直接写名称,那么会只匹配所有名称完全一致的数据。
可以进行的查询:
直接查询 也就是直接编写一个查询语句: 比如 a \ a* \ \a[1-9]\
将会查询:
-
变量名: 得到对应的值
-
函数名:得到函数实例
-
类型名:得到该类型的实例
-
默认情况下,直接查询将会同时进行通用的成员查询。
-
Class
-
Annotation
通用的成员查询,在最前面加. 比如:.a \ .a* \ \.a[1-9]\ *.a
将会查询
- 成员名字匹配,比如b.a = 1, 那么查询
.a的时候将会得到1这个值。
成员查询,通过.进行, 比如:a.b`a*.*b\a[1-9].b`
第一步将进行.前面的直接查询,然后对于得到的结果进行成员的查询。
比如
a = {}
b = {}
a.a = 1
b.a = 2
查询.a 将会得到1,2,而查询a.a得到1, 查询b.a得到2
函数调用关系,通过()表示,比如: a() 表示得到a这个函数调用
函数调用时的参数,通过(sfStatement, )表示,
比如:
a(* as $args)其中的 args变量将会保存所有的a函数调用的参数。a(* as $arg, ), 其中的arg将会保存a函数调用的第一个参数。
多语句和变量#
SyntaxFlow中的语法支持多行语句,但是每个语句本身是独立的互相不干预,因此引入了变量可以保存查询或筛选的结果。
使用as $xx表示保存数据到xx这个变量中,比如: a as $target
同样在另一个查询语句中也可以直接使用变量进行数据处理:
$target.b as $target2 和 a.b as $target2是等效的。
数据流分析#
使用
-> 表示查找使用,--> 表示低级使用
#> 表示找到定义,#-> 表示顶级定义,
比如以下的java代码:
package com.sast.astbenchmark.model;

public class CmdObject {
    private String cmd1;
    private String cmd2;

    public void setCmd(String cmd) {
        this.cmd1 = cmd;
    }

    public void setCmd2(String s) {
        this.cmd2 = s;
    }

    public String getCmd() {
        return this.cmd1;
    }

    public String getCmd2() {
        return this.cmd2;
    }
}
@RestController()
public class AstTaintCase001 {
  @PostMapping(value = "case022-2")
  public Map<String, Object> aTaintCase022_2(@RequestParam String cmd) {
      Map<String, Object> modelMap = new HashMap<>();
      try {
          CmdObject simpleBean = new CmdObject();
          simpleBean.setCmd(cmd);
          simpleBean.setCmd2("cd /");
          Runtime.getRuntime().exec(simpleBean.getCmd());
          modelMap.put("status", "success");
      } catch (Exception e) {
          modelMap.put("status", "error");
      }
      return modelMap;
  }
}
使用Runtime.getRuntime().exec(* #-> * as $target)查询,得到结果如下:
Parameter-cmd
#{id: v}-> -{}->